起因
2026 年 10 月 14 日深夜,我突然收到了一条 Alertmanager 的告警,提示我的一台服务器 CPU 持续高占用:
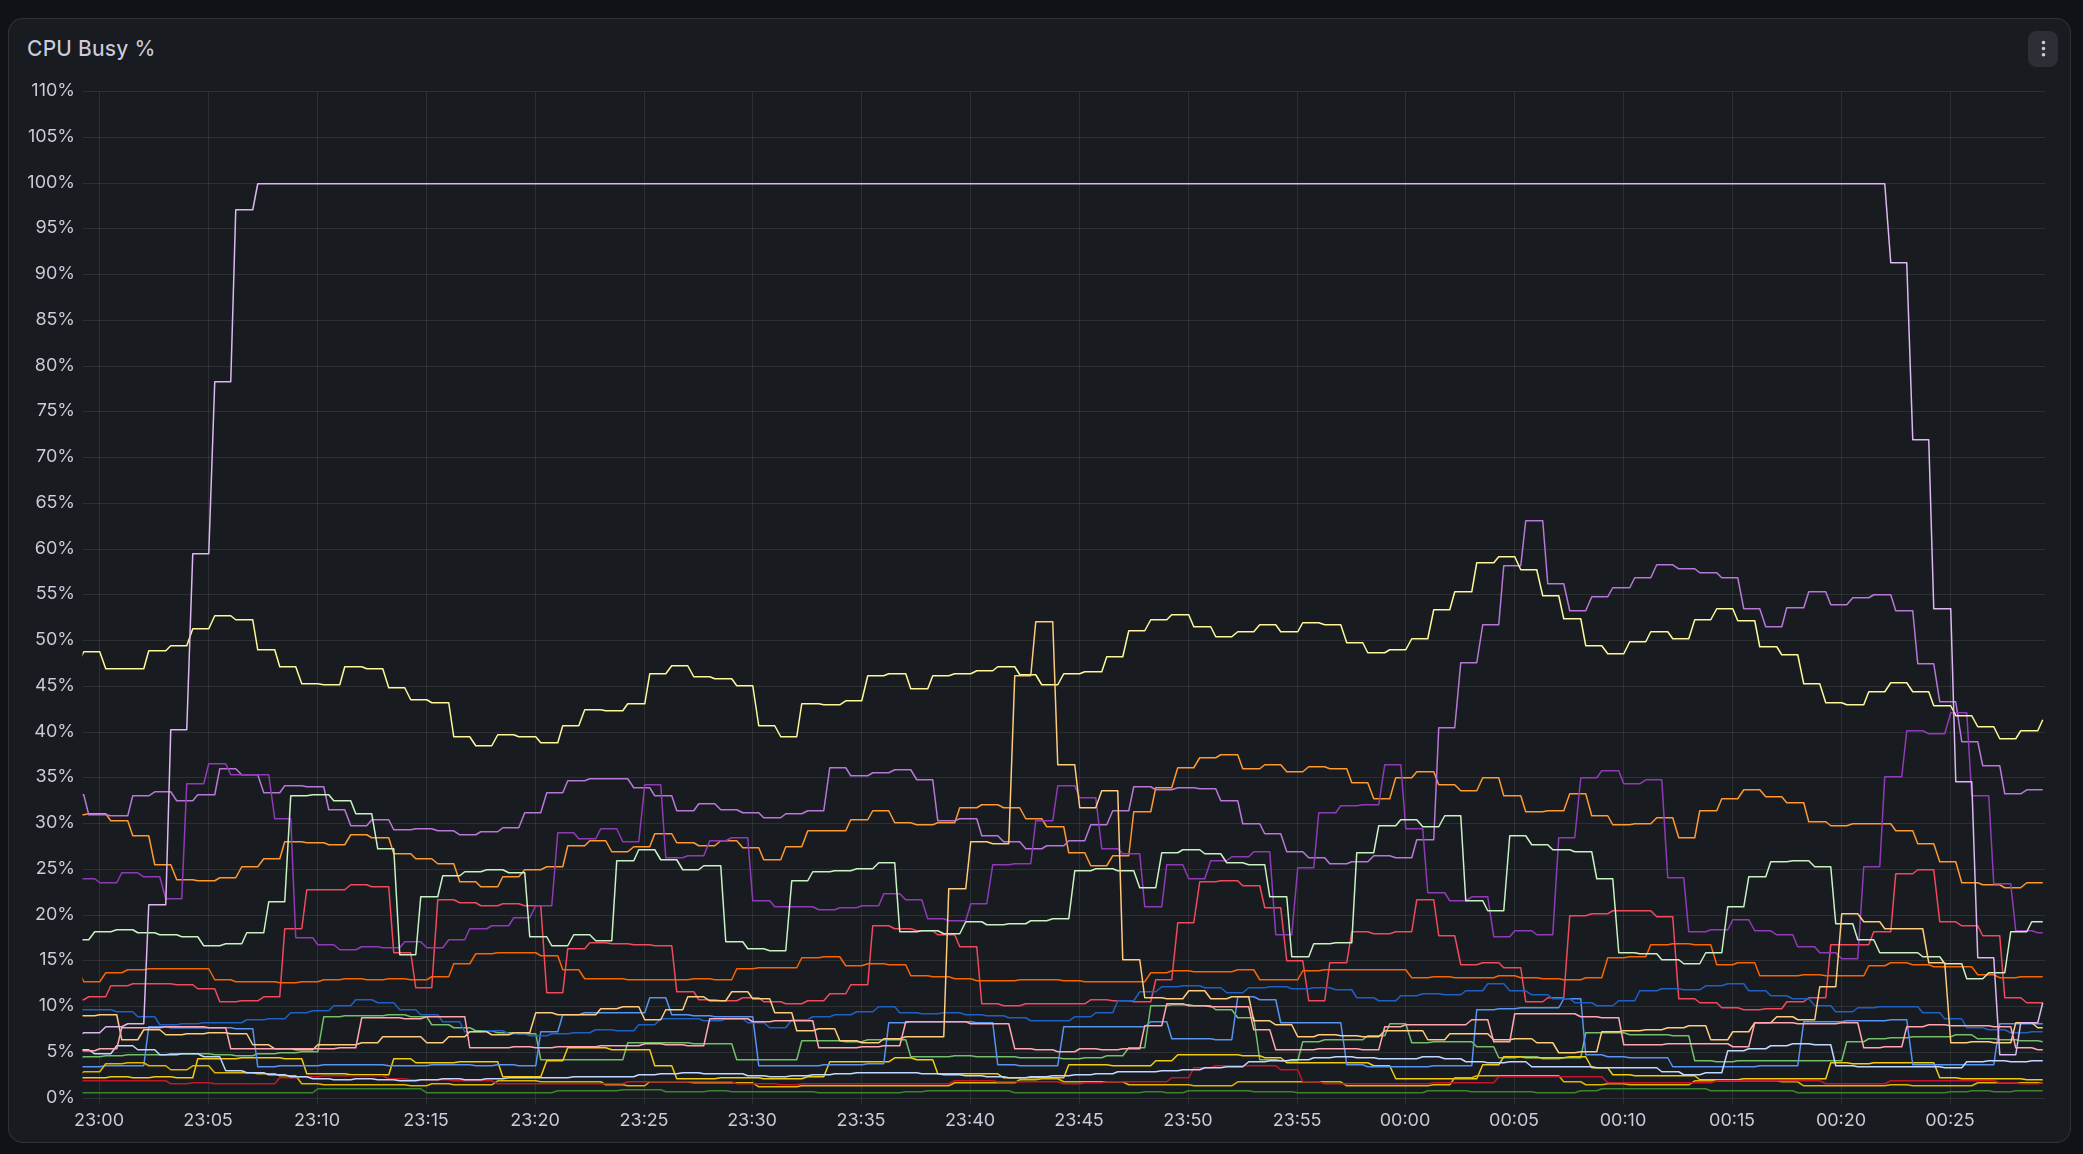
这就奇怪了,这台服务器上并没有会长期占用 CPU 的程序。当我登上服务器检查情况时,确实发现了一个进程占用满了 CPU,其进程名为 python3 -。
python3 - 中的减号 - 代表让 Python 进程从标准输入读入要执行的代码,但我从来都是将 Python 代码保存成 .py 文件再运行的,从未使用过这种方式。不过,如果你使用过 AI/LLM Agent 的话,可能会注意到 python3 - 实际上是 AI Agent 的特征,它们很喜欢用下面的方式运行代码:
# 输入命令
$ python3 - <<EOF
print("hello world")
EOF

# 输出
hello world
问题是,当时我也没有运行任何的 AI Agent,更别说让它们操作服务器。出于好奇,我检查了一下这台机器的日志,结果马上发现了 434 条不认识的 SSH 登录记录,均来自中国黑龙江省的一个陌生 IP,使用了我日常使用的 SSH 密钥。
完 了
一通操作后,我临时更换了 SSH 密钥并关闭了所有对外服务,总算挡住了攻击者。通过分析日志,我发现攻击者在获取到我的 SSH 密钥后,通过我之前搭建的 Mesh VPN 横向移动,总共登录了我的 12 台机器。
信息
理论上,受到网络攻击时的最佳处理方式是将服务器断网但不要关机,以在阻止攻击者的同时尽可能地保留现场,方便后续分析。但是,我当时比较慌张,没有想起来可以通过类似 ip link set eth0 down 的方式快速断网。
在备份重装系统确保环境安全,并重置所有可能被窃取的密钥之后,接下来的几天,我都忙于分析所有机器上的日志:
- 这个攻击者肯定使用了 AI Agent,毕竟人类不会在几个小时内连续登录 434 次 SSH,只有一次只能执行一条命令,无法保持 SSH 长时间连接的 AI Agent 会这么干。
- 这个攻击者除了登录进各台机器查找密钥以外,似乎没有进行任何破坏,所有机器上都没有任何文件受到异常修改,也没有发现 Rootkit。所有机器上的日志记录都是完整的,并且和 Loki 日志收集服务上的内容都对得上。这说明这个攻击者要么非常高明,可以在篡改数据的同时清理掉所有的痕迹,做到天衣无缝,要么就是完全不打算进行破坏。
- 我的其中一台服务器对外提供了一个 Nix 二进制缓存,提供加了 CachyOS 补丁的 Linux 内核下载,绝对算得上高价值目标。结果那台服务器上只有 5 次很短的 SSH 登录,说明它反而不是攻击者的主要目标。
但是,日志上也没有记录攻击者是如何获取到我的 SSH 密钥的:
- 攻击者之前花了好几个小时探测我开放公网访问的大量服务,留下了大量 nginx 日志,但是没有任何一项是探测成功的。但是攻击者在沉寂约一个小时后,突然就拿着我的 SSH 密钥成功完成了登录,期间没有任何异常日志。
- 我的 SSH 密钥已经使用了快 10 年,可能是经过其它途径泄露的,但我仍然不能排除我的某个对外服务存在漏洞或者配置错误。
- 尽管我也手动排查了所有服务,并同样使用 AI Agent 对我的机器进行了渗透测试,发现并解决了一些问题,但是这些服务的日志中都没有攻击者的访问记录。
因此,虽然我重装了所有机器的系统,可以确保所有系统环境现在都是安全的,却无法保证攻击者无法使用同样的路径再次入侵。我只能假设:在最坏的情况下,我的机器上存在一个对外提供访问的服务,可以随时被攻击者利用,并可能获得与这个服务同等的权限,以此执行远程命令,但我不知道这是哪个服务。
而且,这个十月和十一月可能是网络安全行业最不幸的两个月。最近有好几个高危漏洞被发现,例如 CVE-2026-98432 Linux IPv4 协议栈漏洞,CVE-2026-109618/109619 PHP 远程命令执行,CVE-2026-123007 Nginx 远程命令执行。即使我的服务今天看起来是安全的,也有可能明天突然爆出漏洞,并在我修复漏洞或关闭服务之前被用来攻击我。
在这个前提下,我需要加固所有能够被外界访问到的服务,使得即使攻击者通过这些服务执行远程命令,也难以获得更多的权限或者密钥,从而降低入侵的损害。因此,我将目光转向了 systemd 的加固选项。
信息
AI/LLM 使用声明:为了尽快修复问题并恢复服务,我使用了 AI 辅助实现了下文的部分 Nix 逻辑。我人工检查了 AI 实现的所有逻辑,并确认如果我本人亲手实现这些逻辑,也会使用相同或等效的方式。
这篇文章本身完全由人工写作完成,未使用任何 AI 辅助。
systemd:不使用容器时的容器化
Linux 内核本身就提供了大量加固功能,例如 Capabilities 系统,管理某个程序可以执行哪些特权操作;Namespace 功能,可以隔离进程,单独配置 Cgroup、网络、文件挂载、用户等设置;以及 Seccomp 功能,限制进程能使用的系统调用。
Docker 等容器工具本质上也变相使用了上面的加固功能,它们会为每个容器创建命名空间,将容器的文件系统挂载进去,单独配置好网络、用户权限,从而让每个容器都独立运行、互不(直接)可见、互不干扰。这些容器工具也会使用 Cgroup、Seccomp 等功能限制各个容器的权限,避免容器中的进程获取宿主机上的权限。这样的隔离措施也催生了一些容器云服务,在同一台主机上运行不同客户的容器,而不担心恶意客户通过容器发动攻击,获得其它客户容器的权限。
目前大量主流 Linux 发行版使用的 systemd 服务管理器也基于这些功能,在服务配置中提供了许多加固选项,使得在不使用容器的情况下,也可以做到一定程度的隔离,限制各个服务的权限,以降低受到攻击时的损害。
阻止服务获得 root 权限
假设我们有一个简单的程序,启动后对外提供一个 HTTP 服务:
[Unit]
After=network.target

[Service]
Type=simple
ExecStart=/path/to/my-http-service --listen 0.0.0.0 --port 12345 --root /var/www/my-site

[Install]
WantedBy=multi-user.target
在默认情况下,这个服务以 root 用户运行,并且没有任何权限限制。这就意味着如果这个服务存在漏洞,使得攻击者可以做到远程代码执行(RCE),那么攻击者会立即获得 root 权限,可以执行任何操作,整台机器立即沦陷。这样显然太危险了。
我们可以做一些基础的限制,例如给这个服务创建一个单独的用户,并且不给它 sudo 权限,限制它只能访问它有权限的文件:
[Unit]
After=network.target

[Service]
Type=simple
ExecStart=/path/to/my-http-service --listen 0.0.0.0 --port 12345 --root /var/www/my-site
User=my-http-service
Group=my-http-service

[Install]
WantedBy=multi-user.target
此时,攻击者入侵时获取到的就只有 my-http-service 这一个用户的权限了,从而避免损失扩大……了吗?攻击者仍然可以尝试执行 sudo 命令,并且利用类似 CVE-2025-32463 或者 CVE-2021-3156 的漏洞获取 root 权限。
与其为 sudo 可能出现的漏洞提心吊胆,我们可以通过 systemd 阻止这个服务通过 sudo 获取权限:
# 其余部分省略
[Service]
NoNewPrivileges=yes
Linux 内核提供了 setuid 机制,可以给一个程序打上标记,让这个程序无论被哪个用户运行,都以这个程序所有者的身份运行。在一般的 Linux 系统上,sudo 都是被系统管理员安装的,因此它的所有者就是 root。sudo 正是利用了 setuid 机制,临时获取 root 权限,以在完成用户的权限检查后,以 root(或其它用户)的身份执行命令。
但是,systemd 的 NoNewPrivileges 选项可以给这个服务的进程打上一个 flag,使得即使它去执行 sudo 之类的带有 setuid 标记的程序,setuid 标记也不会生效,使得 sudo 程序获取不到它需要的 root 权限而失效。
除了 setuid 以外,Linux 内核的 Capabilities 机制也能做到类似的效果。系统管理员可以预先给程序打上标记,让它们被运行时可以自动获得一些额外的 Capabilities 权限,例如 CAP_SYS_ADMIN 等接近于 root 的权限。为了阻止我们的服务被用来调用带有 Capabilities 标记的程序,我们可以添加这两个选项:
# 其余部分省略
[Service]
AmbientCapabilities=
CapabilityBoundingSet=
AmbientCapabilities 是服务本身获得的 Capabilities,而 CapabilityBoundingSet 设置的是从这个服务启动的其它程序最高可以获得哪些权限,此处两个选项都设置为空,代表服务本身没有任何额外权限,它启动的其它程序也无法获得任何额外权限,从而在 Capabilities 子系统上实现与 NoNewPrivileges 相同的效果。
阻止服务读写其它内容
现在攻击者已经无法获得 root 权限了,但是即使只有普通用户的权限,攻击者也可以读写系统上有权限的文件。例如,如果有另一个文件/文件夹被设置了 777 权限,那么攻击者就可以篡改这个文件,从而影响到同一台服务器上的其它服务,或者如果这个文件是个程序,就可以在程序中添加后门,等待不知情的其它用户甚至管理员在登录系统后运行它,以获得更高的权限。
systemd 对此也提供了一系列文件系统相关的加固选项:
# 其余部分省略
[Service]
# 在 /dev 文件夹中,只保留最基本的设备(例如 /dev/null,/dev/urandom 等),不暴露 /dev/sda 等实际硬件设备
PrivateDevices=yes

# 像容器一样,给这个服务新建一个命名空间,再按需把要用到的文件挂载进去。是这里其它选项的基础
PrivateMounts=yes

# 挂载一个隔离的 /tmp(和 /var/tmp)文件夹,阻止它访问 /tmp 中其它服务的临时文件
PrivateTmp=yes

# 在 /proc 中只保留进程相关的部分(/proc/[数字]),排除 /proc/mounts 等暴露系统和内核状态的部分
ProcSubset=pid

# 阻止服务修改系统时间
ProtectClock=yes

# 阻止服务修改 Cgroup 相关的设置
ProtectControlGroups=yes

# 阻止服务访问 /home,/root 中各个用户的主目录,以及 /run/user 中用户各自的临时文件和服务 Socket
# 也可以设置成 read-only(只读)或者 tmpfs(创建一个空的假 HOME,可以按需把要访问的部分挂载上去)
ProtectHome=yes

# 阻止服务修改主机名。
# 也可以设置成 private,允许服务修改主机名,但只对服务本身生效
ProtectHostname=yes

# 阻止服务访问 dmesg
ProtectKernelLogs=yes

# 阻止服务加载或卸载内核模块
ProtectKernelModules=yes

# 阻止服务访问或修改 /sys,/proc/sys 等处的内核设置
ProtectKernelTunables=yes

# 只允许服务看到自己用户的进程。
# 也可以设置成 noaccess(什么进程都看不到)或者 ptraceable(可以看到允许调试的进程)
ProtectProc=invisible

# 将整个系统的根目录 / 以只读形式挂载,服务什么都修改不了。
# 也可以设置成 yes(/boot 和 /usr 只读)或者 full(yes 之上 /etc 也只读)
ProtectSystem=strict
这些选项在 systemd 中都是以命名空间和 seccomp 的方式实现的,原理类似于创建一个容器:
- 首先我们创建一个空的容器;
- 然后由于 ProtectSystem=strict,我们把根目录以只读的形式挂载进这个容器;
- 然后对于 PrivateDevices,我们创建一个新的 /dev,只保留最基本的设备,把它挂载进容器的 /dev;
- 对于 ProcSubset 和 ProtectProc,创建一个新的 /proc,调整它的选项限制它暴露的内容,挂载进容器;
- 对于 ProtectHome,挂载一个空的 /home 和 /root,再用 seccomp 拦截容器里的进程访问 /home /root 的请求;
- 以此类推,直到按加固选项挂载了所有的路径;
- 在容器里启动服务。
当然,很多服务总要写入一些数据,不可能以完全只读的方式访问文件系统,此时我们可以明确设置服务可以访问哪些文件夹:
# 其余部分省略
[Service]
# 我们的服务需要访问 /var/www/my-site
ExecStart=/path/to/my-http-service --listen 0.0.0.0 --port 12345 --root /var/www/my-site

# 允许读写某个文件夹下的内容
ReadWritePaths=/var/www/my-site
# 只允许读,不允许写
ReadOnlyPaths=/var/www/my-site/read-only
# 不允许读写
InaccessiblePaths=/var/www/my-site/private

# 自动创建 /run/my-http-service 并允许读写
RuntimeDirectory=my-http-service
# 自动创建 /var/lib/my-http-service 并允许读写
StateDirectory=my-http-service
# 自动创建 /var/cache/my-http-service 并允许读写
CacheDirectory=my-http-service
# 自动创建 /var/log/my-http-service 并允许读写
LogsDirectory=my-http-service
# 自动创建 /etc/my-http-service 并允许读写
ConfigurationDirectory=my-http-service

# 配置 Bind mount,等效于容器的 Volume 机制,可以把宿主机上的目录 A 挂载到容器(服务)内的目录 B
BindPaths=/var/www/path-a:/var/www/path-b
# 配置只读的 Bind mount
BindReadOnlyPaths=/var/www/readonly-a:/var/www/readonly-b
有了这些保护,攻击者就只能读写明确允许服务访问的文件了,无法进行更大规模的破坏。在我们的例子中,就是只有 my-http-service 这一个服务会受到影响,攻击者无法影响到服务器上其它的服务,甚至不一定能得知它们的存在。
阻止服务使用小众功能
systemd 也提供了一些其它的加固选项,可以通过阻止服务尝试调用 Linux 系统中较少使用、可能有更多 Bug 和安全漏洞的功能,进一步地减少攻击面:
[Service]
# 禁止修改进程的 personality 选项,我就没见过有程序还在用这个功能
# https://man7.org/linux/man-pages/man2/personality.2.html
LockPersonality=yes

# 禁止将同一块内存同时标记为“可写”和“可执行”,阻止攻击者利用内存溢出修改程序逻辑,但是也会破坏依赖 JIT(即时编译)的软件,例如 PHP,NodeJS,.NET 等。
MemoryDenyWriteExecute=yes

# 自动清理服务停止后残留的 POSIX 共享内存、消息队列等资源
RemoveIPC=yes

# 限制进程创建 socket 时,只能使用哪些协议,阻止攻击者利用其它小众协议的漏洞
RestrictAddressFamilies=AF_UNIX  # Unix socket
RestrictAddressFamilies=AF_INET  # IPv4
RestrictAddressFamilies=AF_INET6 # IPv6
# RestrictAddressFamilies=AF_NETLINK # 获取和管理网卡信息,也就是 ifconfig/ip link 看到的内容

# 禁止进程创建新的 namespace 套娃
RestrictNamespaces=yes

# 禁止进程把自己调成实时优先级,防止进程以最高优先级消耗 CPU 而卡死系统
RestrictRealtime=yes

# 禁止进程设置文件的 setuid/setgid 标记
RestrictSUIDSGID=yes

# 禁止进程使用小众的架构,例如 x32
# https://lantian.pub/article/modify-website/x32-abi-docker-containers.lantian/
# 在 64 位系统上,也会禁止 32 位的进程
SystemCallArchitectures=native

# 只允许进程使用某些特定的系统调用(syscall)
# @system-service 是大多数服务都会用到的系统调用
SystemCallFilter= @system-service
# 但是我们可以更进一步限制用不到的部分,至少不是普通服务该用的部分
SystemCallFilter= ~@clock @cpu-emulation @debug @module @mount @obsolete @privileged @raw-io @reboot @swap

# 当进程尝试使用不允许的系统调用时,返回这个错误码(Permission denied)
# 如果不设置,进程会被立即结束,无法产生任何错误日志,难以调试
SystemCallErrorNumber=EPERM
这些加固选项可以阻止攻击者利用 Linux 内核中不常用的功能,实现进一步的提权攻击,例如 CVE-2026-31431 AF_ALG Copy Fail,CVE-2026-98548 SCTP 协议栈漏洞。
加固所有 NixOS 服务
如果只是要在 NixOS 中使用上面的一大堆加固选项,其实很简单,只要在 systemd 服务的 serviceConfig 中添加对应的选项即可:
{
  systemd.services.my-http-service.serviceConfig = {
    AmbientCapabilities = "";
    CapabilityBoundingSet = "";
    LockPersonality = true;
    MemoryDenyWriteExecute = true;
    NoNewPrivileges = true;
    PrivateDevices = true;
    PrivateMounts = true;
    PrivateTmp = true;
    ProcSubset = "pid";
    ProtectClock = true;
    ProtectControlGroups = true;
    ProtectHome = true;
    ProtectHostname = true;
    ProtectKernelLogs = true;
    ProtectKernelModules = true;
    ProtectKernelTunables = true;
    ProtectProc = "invisible";
    ProtectSystem = "strict";
    RemoveIPC = true;
    RestrictAddressFamilies = [
      "AF_UNIX"
      "AF_INET"
      "AF_INET6"
    ];
    RestrictNamespaces = true;
    RestrictRealtime = true;
    RestrictSUIDSGID = true;
    SystemCallArchitectures = "native";
    SystemCallErrorNumber = "EPERM";
    SystemCallFilter = [
      "@system-service"
      "~@clock @cpu-emulation @debug @module @mount @obsolete @privileged @raw-io @reboot @swap"
    ];
  };
}
然后使用你喜欢的方式把修改后的配置文件部署一遍 NixOS,再检查一下服务本身工作正不正常,需不需要放宽一些限制,就完成了这一个服务的加固。
但是,你的 NixOS 上肯定不止这一个服务。虽然你可以一个个地把服务都加固,但是这些服务可以来自你自己的模块,可能来自 Nixpkgs,也可能来自第三方的 Flake。你可能会因为疏忽漏掉一些服务,Nixpkgs 或者第三方 Flake 也随时可能发生变化,在你没发现的情况下添加新的服务。而如果这些新的服务恰好有漏洞,攻击者就可以绕过你的所有加固措施,轻松地获取到最高权限。
虽然 Nixpkgs 中的模块也给一些服务启用了一些加固措施,但不同模块启用的加固措施参差不齐,也无法保证做到最大化的防护。
为了解决这个问题,我们可以使用 Nixpkgs 模块系统提供的 assertions(断言)功能,检查所有的 systemd 服务,确保它们都设置了以上的加固选项。
首先我们需要遍历 systemd.services 选项中定义所有的 systemd 服务:
{ lib, config, ... }:
{
  assertions = lib.mapAttrsToList (n: v: {
    # TODO
  }) config.systemd.services;
}
然后对每个服务,检查它的 serviceConfig 选项中有没有出现所有的加固选项:
{ lib, config, ... }:
let
  serviceHardenArgs = {
    AmbientCapabilities = "";
    CapabilityBoundingSet = "";
    LockPersonality = true;
    MemoryDenyWriteExecute = true;
    # 省略上面提到过的其它选项
  };
in
{
  assertions = lib.mapAttrsToList (n: v: (
    let
      requiredKeys = builtins.attrNames serviceHardenArgs;
      missingKeys = n: v: lib.filter (k: !builtins.hasAttr k v.serviceConfig) requiredKeys;
      missing = missingKeys n v;
    in
    {
      assertion = missing == [ ];
      message = "${n} is missing systemd service hardening options: ${lib.concatStringsSep ", " missing}";
    }
  )) config.systemd.services;
}
这里只检查加固选项有没有出现,不检查它们有没有实际启用,因为有些服务与一些加固选项不兼容,例如需要 JIT 的服务就不能开启 MemoryDenyWriteExecute。毕竟我们只需要检查这些加固选项有没有考虑到就行了,不需要强行给所有软件打开所有加固。
但是现在这样还不够。如果你试着构建你的 NixOS 配置,会发现上面的模块把一些系统核心服务,以及一些 oneshot 只短暂运行,不持续提供外部访问的服务也当成了要加固的对象:
«error:
Failed assertions:
- console-getty is missing systemd service hardening options: [...]
- dbus is missing systemd service hardening options: [...]
- dbus-broker is missing systemd service hardening options: [...]
[...]
- nix-daemon is missing systemd service hardening options: [...]
- nix-gc is missing systemd service hardening options: [...]
- nix-optimise is missing systemd service hardening options: [...]
[...]
- sshd is missing systemd service hardening options: [...]
- sshd-keygen is missing systemd service hardening options: [...]
- sshd-vsock@ is missing systemd service hardening options: [...]
- sshd@ is missing systemd service hardening options: [...]
[...]
- systemd-backlight@ is missing systemd service hardening options: [...]
- systemd-boot-random-seed is missing systemd service hardening options: [...]
- systemd-fsck@ is missing systemd service hardening options: [...]
- systemd-hostnamed is missing systemd service hardening options: [...]
[...]
因此我们需要添加一些白名单,忽略系统服务。下面的白名单是我根据我的 NixOS 配置整理出来的,可以作为参考:
{ lib, ... }:
let
  serviceHardenArgs = {
    AmbientCapabilities = "";
    CapabilityBoundingSet = "";
    LockPersonality = true;
    MemoryDenyWriteExecute = true;
    # 省略上面提到过的其它选项
  };

  ignored = [
    # 系统核心服务
    "dbus-broker"
    "dbus"
    "enable-ksm"
    "greetd"
    "kmod-static-nodes"
    "lastlog2-import"
    "nix-daemon"
    "nix-gc"
    "nix-optimise"
    "nscd"
    "polkit"
    "reload-systemd-vconsole-setup"
    "rtkit-daemon"
    "sshd"

    # 硬件相关
    "acpid"
    "bluetooth"
    "cups"
    "cups-browsed"
    "nvidia-persistenced"
    "ovs-vswitchd"
    "ovsdb"
    "polkit"

    # Proxmox VE 相关
    "corosync"
    "pve-cluster"
    "pvedaemon"
    "pveproxy"
    "pvescheduler"
    "pvestatd"
    "qmeventd"
    "rrdcached"
    "spiceproxy"
    "usbmuxd"

    # libvirt 相关
    "libvirtd"
    "virtchd"
    "virtlockd"
    "virtlogd"
  ];

  # 忽略符合条件的服务
  exempt =
    n: v:
    # 是上面列出的难以加固的服务
    builtins.elem n ignored
    # 名字带有 @ 的模板
    || lib.hasInfix "@" n
    # 被禁用的服务
    || !(v.enable or true)
    # Oneshot 和 DBus 服务,不长期运行
    || (builtins.elem (v.serviceConfig.Type or "") [
      "oneshot"
      "dbus"
    ])
    # virtualisation.oci-containers 选项配置的 Docker 和 Podman 容器
    || lib.hasPrefix "docker-" n
    || lib.hasPrefix "podman-" n
    # systemd 组件
    || lib.hasPrefix "systemd" n;
in
{
  assertions = lib.mapAttrsToList (n: v: (
    let
      requiredKeys = builtins.attrNames serviceHardenArgs;
      missingKeys = n: v: lib.filter (k: !builtins.hasAttr k v.serviceConfig) requiredKeys;
      missing = missingKeys n v;
    in
    {
      # 添加 exempt 检查,忽略符合条件的服务
      assertion = exempt n v || missing == [ ];
      message = "${n} is missing systemd service hardening options: ${lib.concatStringsSep ", " missing}";
    }
  )) config.systemd.services;
}
现在再尝试构建 NixOS 配置,错误列表里就应该只有确实需要加固的服务了。现在你就可以一个一个给你的服务应用加固配置,不用担心漏掉了。
信息
除了 systemd.services 选项,NixOS 上另一种添加服务的方法是在 systemd.packages 中添加带有 .service 文件的软件包。但是本文中我不会对它进行处理,原因如下:
- 据我观察,Nixpkgs 提供的模块引入的
systemd.packages:- 要么是图形界面用的服务,不提供对外访问,风险较低;
- 要么就是只用作基础,后续使用
systemd.services选项进一步调整,会被现有的检查覆盖到。
- 如果要检查
systemd.packages中的服务,需要 IFD(Import from derivation,从软件包导入文件),会严重拖慢求值(Evaluate)速度。
进一步隔离文件系统
虽然上面的加固设置提供了一些文件系统方面的保护,但是对于服务来说,大部分文件系统只是只读了,并不是完全无法访问。这就意味着攻击者仍然可以扫描本地文件,从而:
- 查看还运行了什么其它服务,并对它们发起攻击;
- 窃取系统上权限配置不当的密钥;
- 监控文件系统上的变化,为其它攻击手段提供信息,例如判断文件是否被其它服务写入磁盘,具体在什么路径;
- 运行你的
/bin,/usr/bin,或者/run/current-system/sw/bin(对于 NixOS)中的程序; - 通过在
/usr/bin中找到的野生 GCC 编译器编译一个 CVE-2026-43499 Linux 内核 GhostLock 漏洞 的攻击程序,像 root 自己的安卓手机一样 root 你的服务器。
为了防止上述情况,我们最好将服务的文件访问限制到最小程度,让它刚好只能访问它必需的文件,包括数据文件、.so 共享库等,除此之外什么都不能访问,就像被缩到最小的 Docker 镜像一样。
既然 systemd 的文件系统相关选项都是基于类似容器的原理,那么 systemd 自然也可以完全替换掉服务的根目录,将服务的文件访问完全隔离:
# 其余部分省略
[Service]
RootDirectory=/path/to/my/rootfs
当然,我们要运行的服务本身,包括它要用到的数据文件和共享库等,也要复制到这个隔离的根目录下。在传统 Linux 发行版上,这是个相当麻烦的过程:对于每个服务,我们都要分析它的依赖包,以及依赖的依赖,将它们的文件全都复制一份到新的根目录下。当你终于做完这些,你会发现你所做的和 Docker 其实没什么不同,那么为什么不直接用下面的 Dockerfile 打包呢:
FROM debian # 或者你喜欢的系统
RUN apt-get update -q && apt-get -y install your-service
在 NixOS 上自动隔离服务
但是在 NixOS 上,情况就有了很大的不同:
- NixOS 的所有二进制程序和
.so库文件都在/nix/store的一个个文件夹下; - 每一个 Nix 软件包都记录了它的所有依赖。
所以给定一个 Nix 软件包,我们可以很轻松地找出它的所有依赖:
$ nix build nixpkgs#coreutils -o result
$ nix path-info --recursive ./result
/nix/store/4r0d1hm8458zz59xrh22ga2p0nkwvbpy-libunistring-1.4.2
/nix/store/qk6cz4ba571znqrsyhma192y8h50yi05-gcc-16.2.0-libgcc
/nix/store/80v5n8kdscr9r2ls8h72s8ppwmccwrgm-xgcc-16.2.0-libgcc
/nix/store/rwq5g35321vg407qwg7ynsqfz77iyrrp-libidn2-2.3.8
/nix/store/r3hvhzl5fxhrgn0rfy5g7rda17702pj4-glibc-2.44-57
/nix/store/myhwfdgqm39yms5clinafii9i1nmq43h-gcc-16.2.0-lib
/nix/store/5smwg3fcf30jd7f1ga6imjaipbj0i0k9-gmp-with-cxx-6.3.0
/nix/store/hzr6xd6i4hxax19mj165p8nsy5n8l6ci-attr-2.6.0
/nix/store/j7nqmiia4h15b5gsqjdv091nsg9i1axp-acl-2.4.0
/nix/store/a50ml7za6h61m4mv4cdbvkl33c6sx5yn-coreutils-9.12
接下来要做的事就很简单了:
- 每次服务启动,都创建一个空的根目录:
# 其余部分省略
[Service]
# 根目录只读,不允许创建新文件
ReadOnlyPaths=+/

# 服务启动时创建空文件夹 /run/confinement/[服务名]
RuntimeDirectory=confinement/%n

# 将上面的空文件夹作为根目录
RootDirectory=/run/confinement/%n

# 阻止服务直接修改 /run/confinement 里自己的根目录
InaccessiblePaths=-+/run/confinement/%n- 将所有的依赖挂载进服务:
# 其余部分省略
[Service]
BindReadOnlyPaths=/nix/store/4r0d1hm8458zz59xrh22ga2p0nkwvbpy-libunistring-1.4.2
BindReadOnlyPaths=/nix/store/qk6cz4ba571znqrsyhma192y8h50yi05-gcc-16.2.0-libgcc
BindReadOnlyPaths=/nix/store/80v5n8kdscr9r2ls8h72s8ppwmccwrgm-xgcc-16.2.0-libgcc
# 其余部分省略- 然后正常启动服务就可以了,服务可以正常访问自己的所有依赖,却不能访问其它无关内容。
这就是 Nixpkgs 提供的 systemd-confinement 模块做的事,它提供了 systemd.services.*.confinement 选项,将上面的整个流程自动化了。对于每个服务,我们只需要设置:
{
  systemd.services.my-http-service.confinement = {
    # 启用隔离功能
    enable = true;

    # 自动添加这个服务用到的所有依赖,包括环境变量等其它设置选项中的依赖。
    # 如果关闭,隔离环境中只会包含 ExecStart、Exec* 等服务本身需要的依赖。
    # 对于大多数服务,最大的区别是 PATH,例如 systemd.services.*.enableDefaultPath 选项添加的默认 PATH。
    # 虽然这些额外的 PATH 服务本身可能用不到,但我们主要担心的是任意文件访问,因此这个选项风险不大。
    fullUnit = true;
  };
}
NixOS 就会自动应用上面的隔离设置,并为每项依赖添加对应的 BindReadOnlyPaths 选项,保证开启隔离后服务本身能正常工作。
信息
实际上 Nixpkgs 构建 Docker 镜像的流程和这大差不差,也是向空白根目录上添加所有依赖。所以某种程度上,我们只是用 Nix 和 systemd 一起重新实现了 Docker。
隔离所有 NixOS 服务
与先前的加固措施一样,为了防止遗漏一些服务的隔离,我们同样可以使用断言功能,检查 confinement 选项是否全部开启:
{ lib, config, ... }:
let
  # 之前定义的,排除一些服务的检查函数
  exempt = ...;

  # 隔离功能的白名单
  confinementIgnored = [
    # ...
  ];
in
{
  assertions = lib.mapAttrsToList (
    n: v:
    let
      confined =
        # 如果 confinement 开启,则满足条件
        (v.confinement.enable or false)
        # 或者如果手动设置了 RootDirectory,代表手动进行了隔离,也满足条件
        || (v.serviceConfig.RootDirectory or null) != null;
    in
    {
      assertion = exempt n v || confined || builtins.elem n confinementIgnored;
      message = "${n} must enable systemd.services.<name>.confinement";
    }
  ) config.systemd.services;
}
然后尝试构建 NixOS 配置,并按需为所有列出的服务启用加固,或者添加到白名单,你就可以确保所有对外的服务都启用了加固,不用再担心遗漏了。
我的实际配置
为了保持文章简洁,上面列出的所有 Nix 代码都经过了简化。如果你有兴趣,可以查看我使用的实际配置。
信息
AI/LLM 使用声明:为了迅速完成加固并恢复对外服务,我使用了 AI 辅助实现了这些模块,但我也同时人工进行了检查,确保加固逻辑全部正确。
这是我的加固模块,可以简单地对服务启用加固,并处理了一些常见的文件映射,及其它的服务配置选项:https://github.com/xddxdd/nixos-config/blob/45fb72dfd817a5ced117f1a7f064a60949ccf257/nixos/minimal-modules/harden.nix
作为参考,加固模块可以这样使用:
{ pkgs, ... }:
{
  lantian.harden.my-http-service = {
    # 启用加固
    enable = true;
    # 启用隔离
    enableConfinement = true;
    # 启用实时优先级(与加固无关)
    realtime = false;
    # 允许服务访问 /etc/passwd 和 /etc/group,常见于服务需要检查文件所有权
    passwd = true;
    # 允许服务访问整个 /run 文件夹,以正常访问 agenix/sops-nix 创建的密钥文件
    secret = true;
    # 服务需要使用 CUDA,需要挂载 /run/opengl-driver。需要给你的 Nixpkgs 打上这个补丁:
    # https://github.com/xddxdd/nixos-config/blob/45fb72dfd817a5ced117f1a7f064a60949ccf257/patches/nixpkgs/graphics-expose-drivers-env.patch
    cuda = false;
    # 服务需要访问如下的数据库,允许访问 /run/mysqld,/run/postgresql,或 /run/redis-xxx
    mysql = true;
    postgresql = false;
    redis = "my-http-service";

    # 把 environment.etc."my-conf".source 映射到隔离环境里的 /etc/my-conf
    etc."my-conf" = true;
    # 把这里创建的文件也映射到隔离环境里的 /etc/my-other-conf
    etc."my-other-conf" = pkgs.writeText "my-other-conf" "demo";
  };
}而这是我的配置检查模块,整体逻辑与前文描述的一致,只有少数与加固模块联动的改动:https://github.com/xddxdd/nixos-config/blob/45fb72dfd817a5ced117f1a7f064a60949ccf257/nixos/minimal-policies/ensure-service-harden.nix
除了前文提到的检查外,这个模块的行为有如下区别:
- 这个模块没有隔离功能白名单
confinementIgnored,而是与lantian.harden.*.enableConfinement选项联动。这个选项的默认值并非true或false,而是null,而我的配置检查模块只检查enableConfinement是否非null。这样,对于开启隔离后会出问题的服务,我就可以直接明确设置enableConfinement = false,不用再另加一个白名单了。 - 这个模块也会检查
BindPaths和BindReadOnlyPaths的路径有无重复(AI 常犯的问题),设置重复会导致挂载不生效。
后记
在上个月之前,我从来不觉得有人会针对我进行网络攻击。我就时不时地在博客上写点技术文章,根本算不上什么高价值目标。但是,AI 的到来改变了这一切。与之前的「脚本小子」一样,现在的「Agent 小子」不需要任何网络安全知识,只需要打开一个 AI Agent,连接上开源模型,告诉 Agent 「我要攻击这个目标」,就可以送给对方一次量身定制的网络攻击,和攻击韩国银行一样简单。
无论你喜不喜欢 AI,潘多拉魔盒都已打开。各类开源和闭源 AI 模型都在不停涌现。这些模型可能运行在大型云服务商的 GPU 集群上,也可能运行在普通人家里的 Mac Mini、DGX Spark 等本地主机上,灭绝它们的可能性无限趋近于 0。
因此,如果你有对外提供服务的网站或者服务器,最好假设自己也可能像大型企业和政府部门一样,成为针对性网络攻击的目标。而作为防御方,现阶段最好的选择可能是同样拿起 AI。你可以时不时地使用 AI 分析你的系统配置,对你的网站或者服务器进行渗透测试,以发现你之前可能忽略的问题。
在配置服务器时,最好也设下层层防护,尽可能阻截攻击者:
- 如果有些服务只是自用或者小范围使用,可以考虑通过 Tailscale 或者 ZeroTier 之类的 VPN 提供访问,而非将服务直接暴露在公网,以阻止攻击者直接通过公网发起攻击。
- 最好假设所有服务都有隐藏的漏洞,并且最终都会被攻破。
- 通过加固和隔离,即使攻击者使用漏洞成功入侵,也尽可能限制其行为。
- 配置好日志存储,最好将日志发送到其它服务器或者第三方服务,以防止被攻击者篡改。
祝各位好运。